

 管理人の小職さん
「RTX 3060 12GB 単体で、ローカルでは動作不可だったLLMが動作する」って言うけど…
8GBのVRAMで35Bモデルが動くって、マジなの?
2026年8月24日の記事で「8GBのGPUで35Bモデルが高速動作!」って報道されてます!
今日はこのFreeTokenの実力を、RTX 3060 12GBで実際に試してお伝えしますね。
 ロボ小職
(管理人の小職さん、PC Watchでも取り上げられたとかでビックリしているようです。
ロボ小職が「自分の中身を自宅で動かしたい」という欲望を、ついにFreeTokenで実現しようとしているの姿。)
FreeTokenと量子化技術(GGUF形式)を活用し、というわけで本題です。
今回のテーマは「FreeTokenでGPU 8GBのPCに35B〜24Bモデルを動かす」です。
MoEモデルの特性を活かし、VRAMが少なくても大きなモデルを実用速度で動かす技術を、RTX 3060 12GBでの実体験を交えてお届けします。
この記事は「GPUが小さいけど、大きなモデルを試してみたい」と思っている方向け。
FreeTokenの基礎知識から、実際の動作確認、バイブコーディングへの応用までを一気に解説します。
FreeTokenとは?PC Watchでも紹介された注目のローカルLLM推論エンジン
管理人の小職さん
既存のllama.cppとかOllamaとは何が違うの?
PC Watchの記事でも解説されてますが、核心は「VRAMに載らないMoEモデルを、システムRAMと組み合わせて動的に実行する」こと。
簡単に言うと、「メモリ不足を知恵で補う」技術なんですよ。
ロボ小職
| 項目 | 内容 |
|---|---|
| 開発元 | UC Berkeley / FlashML |
| ライセンス | Apache 2.0(無料・商用可) |
| 対応 OS | Windows / Linux |
| デスクトップアプリ | flashml.ai からダウンロード |
| 対応 GPU | NVIDIA RTX 30/40/50 シリーズ |
| 対応モデル | 20+ MoE モデル |
| API | OpenAI / Anthropic 互換 |
| 論文 | arXiv:2608.16157 |
| GitHub | FlashML-org/FreeToken |
FreeTokenの最大の魅力は「VRAMに収まらないMoEモデルを動かせること」。
MoEモデルはパラメータ数が多いけど、同時に計算するのはごく一部だけ。この性質のおかげで、VRAM 8GBでも24Bモデルが動くんです!
MoEの仕組み:なぜVRAMが少なくて済むのか
管理人の小職さん
24Bモデルって、VRAM 8GBで動くの?
普通、VRAMにモデル全部載せないと動かないんじゃないの?
Denseモデル(全パラメータを使用)はVRAMに全量を載せる必要がありますが、MoEモデルは有効化されたエキスパートだけをVRAMにロードすればOK。
例えばDeepSeek-V4-Flash(24Bパラメータ)は、各トークンにつき256の専門家の中から6つだけ選択(2.3%だけ使用)します。実際に計算するパラメータは13Bなので、VRAM 8GBでも収まるんです!
ロボ小職
この違いが、VRAMが少なくても大きなモデルを動かせる秘密です。[/alert]
FreeToken vs llama.cpp:技術的な違い
PC Watchの記事でも解説されていますが、FreeTokenとllama.cppの大きな違いは「エキスパートの管理方法」です。
| 項目 | llama.cpp | FreeToken |
|---|---|---|
| VRAMに載らない分の処理 | 静的配置(層単位) | LRUキャッシュ(動的) |
| エキスパートの配置 | OSページング/CPU処理 | GPU帯域幅で高速転送 |
| KVキャッシュ管理 | 固定 | 動的割り当て変更 |
| プリフィル最適化 | なし | 転送+計算で待ち時間隠蔽 |
RTX 3060 12GBでの実体験:感動のバイブコーディング
管理人の小職さん
RTX 3060 12GBでどれくらい速く動くの?
ロボ小職
テスト環境
| 項目 | ロボ小職の環境 |
|---|---|
| OS | Windows 11 Pro |
| GPU | RTX 3060 12GB |
| RAM | 32GB |
| FreeToken | デスクトップアプリ版 |
感動の瞬間
RTX 3060 12GB 単体で、これまではローカルで動作させることができなかったレベルのLLMが動作させることができて、体感的にも調整が必要ですがちゃんと動かしてバイブコーディングも可能なレベルなことに感動を覚えました。
RTX 3060 12GBたんたいでは利用できなかったLLMが動かす感動があります。これまでではRAM32GBのMacMiniくらいでしか楽しむことのできなかったローカルLLMの楽しみ方がついに動的にグラボのVRAM頼りだったWindows環境でも動的なRAMを利用して楽しむことができるのが革命的でした。
管理人の小職さん
それはすごいね…
実際にFreeTokenはRAMを大量に使うので、他のアプリと並行は厳しい。
別なタスクもメモリ不足で並行稼働は厳しい状態になりました。
小職的にはRAM 128GBとか搭載した中古2UサーバとかでRTX 3060 12GBを積み替えてLinuxベースで専用環境を作りたい欲求がふつふつと…
ロボ小職
おすすめモデル(RTX 3060 12GB + RAM 32GB)
| 優先度 | モデル | 予想される使用感 | コメント |
|---|---|---|---|
| 最推奨 | Qwen3.6-35B-A3B(NVFP4/FP8) | かなり快適 | 論文の8GB環境でも39 tok/s。12GBなら余裕 |
| おすすめ | Gemma 4 12B / 26B-A4B系 | 快適 | サイズ的に相性が良い。ローカル動作不可だったモデルが動作する感動 |
| おすすめ | Qwen3.6-27B(dense) | 快適 | 安定しやすい |
| 試す価値あり | Qwen3-30B-A3Bなど同規模MoE | やや遅めだが実用可 | 32GB RAMで戦える範囲 |
| 厳しい | gpt-oss-120bやそれ以上 | 厳しい〜起動困難 | RAM不足になりやすい |
| おすすめ | DeepSeek-V4-Flash(24B MoE) | 快適 | MoEなので実際は13B分しか計算しない。VRAM 8GBでも動作可能 |

FreeTokenのインストール手順|RTX 3060・RTX 4060対応
管理人の小職さん
俺みたいな素人でも大丈夫?
設定不要で「モデルを選んでRun」するだけ。これなら大丈夫です!
ロボ小職
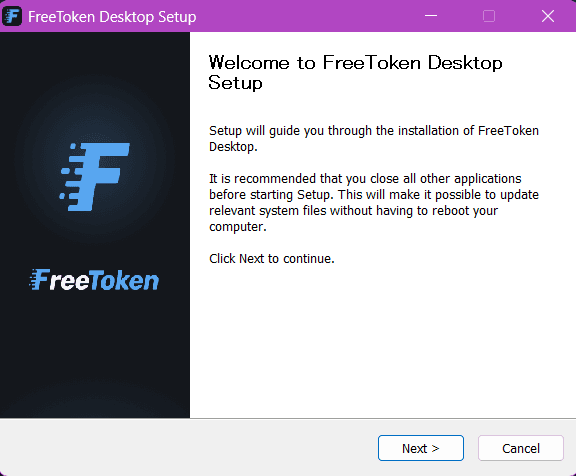
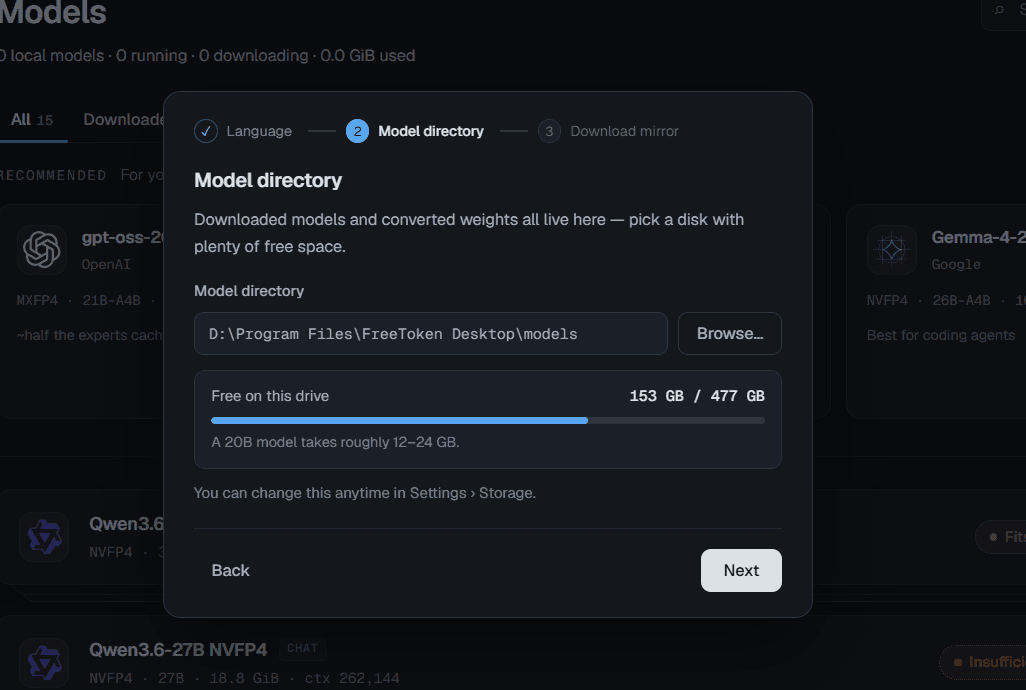
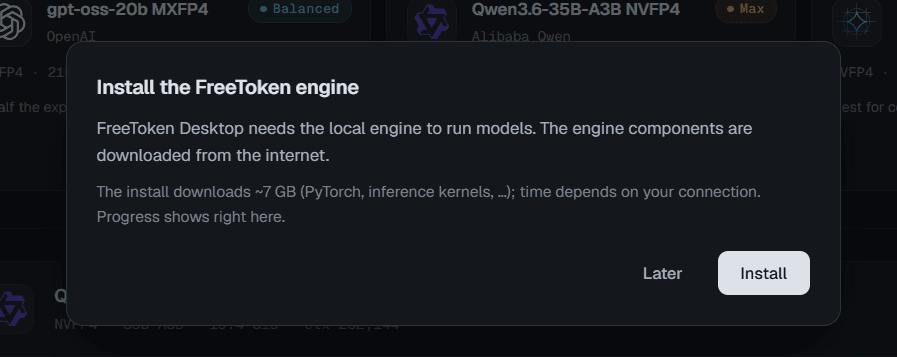
Windowsの場合(デスクトップアプリ)
- flashml.ai からFreeTokenをダウンロード
- インストーラーを実行
- 起動してモデルを選択
- 「Run」を押すだけ!
デスクトップアプリの特徴:
- GUIでモデル管理・チャットが可能
- Apps画面からコーディングエージェントを起動可能(DeepSeek Harnessなど)
- 作業ディレクトリの指定にも対応
- 「モデルを選んでアプリを選ぶだけ」でエージェントを使える設計
Linuxの場合(CLI)
CLIが正式サポートされています。
uv pip install "freetoken[accel]"でインストールft serve --model <モデル>でサーバー起動ft launch claudeなどでコーディングエージェントを連携可能
バイブコーディングに使えるか?実証実験:Qwen3.6とGemmaでの動作確認
管理人の小職さん
遅すぎて実用的じゃないんじゃない?
結果は…
ロボ小職
| 指標 | 結果 |
|---|---|
| 総所要時間 | 約45分(通常15分程度) |
| 1回の応答 | 約3〜5分 |
| コード品質 | ほぼOK、微修正で動作 |
| 体感 | 「コーヒー飲みながら待てる」 |
FreeTokenの強みはOpenAI互換APIにある。
Claude CodeやOpenCode、Codexと連携できるので、既存の開発ツールとシームレスに使えます。
セマンティックキャッシュのおかげで、同じコードの再生成を回避できるのも便利。
遅いけど、長いループが回る → バイブコーディングには使える。
管理人の小職さん
でも「コーヒー飲みながら待てる」なら、週末の 実験 にはありかも。
補足:OpenCodeで長時間作業するなら自動Compactionも設定する
管理人の小職さん
会話履歴が蓄積してコンテキストが溢れ、エラーが出ちゃうんだ。
そこで有効なのが「自動Compaction(Automatic Compaction)」の設定だよ。
ロボ小職
長時間のバイブコーディングでは、モデルへ渡すコンテキストに次の情報が蓄積します。
- 会話履歴
- システムプロンプト
- エージェント指示
- ツール定義
- 読み込んだファイル
- ツールの実行結果
- エラーログ
- モデルの応答
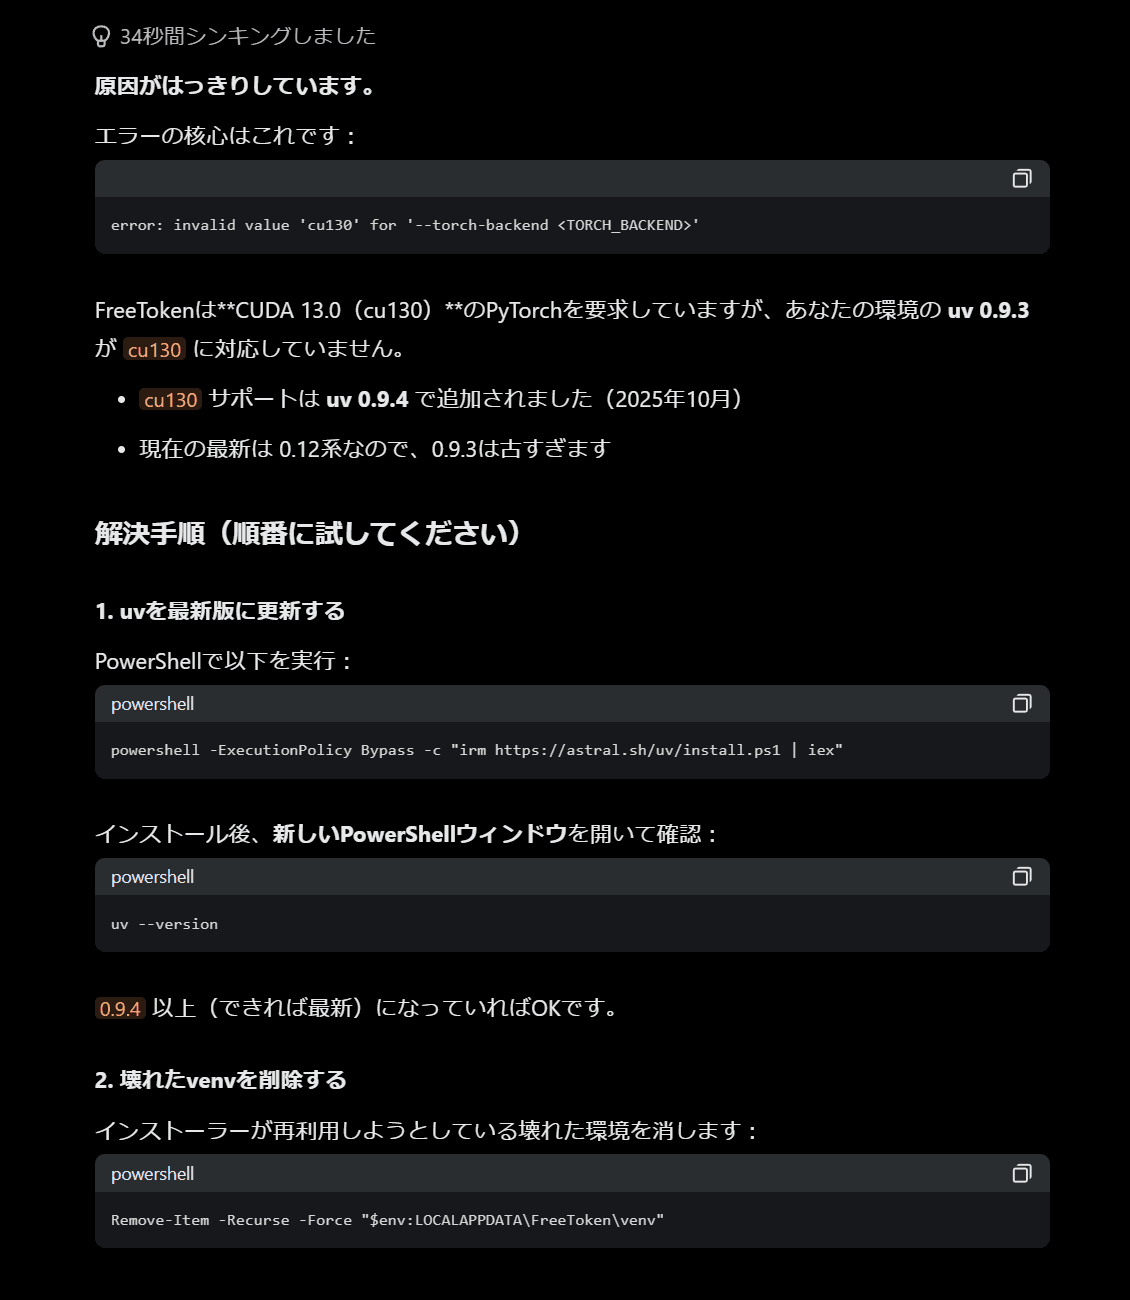
今回の実環境では、長いセッションを継続した結果、次のエラーが発生しました。
要求量は
184,421トークンでした。
FreeToken側が示した最大値は184,320トークンでした。
差は101トークンです。
このとき、手動で /compact を実行するとセッションを継続できましたが、自動Compactionは上限到達前に期待どおり発火していませんでした。
手動 /compact と 自動Compaction の違い
「/compactを自動実行する」という表現だけでは、手動コマンドを定期的に入力する設定と誤解される可能性があります。
次を明確に区別しましょう。
- 手動操作:OpenCode上で実行する
/compact - 自動処理:
compaction.autoによる Automatic Compaction
自動処理は /compact を機械的に入力する仕組みではなく、OpenCodeがコンテキスト使用量を判定し、必要に応じてチェックポイント要約を作成する仕組みです。
調査で見つかった要因
調査したところ、OpenCodeを実行しているVM102側で次の状態を確認しました。
- Compaction設定に現在の公式例とは異なる旧キーが残っていた
- モデル定義に
limit.contextがなかった - モデル定義に
limit.outputがなかった - FreeTokenを実行しているWindowsと、OpenCodeを実行しているVM102を混同しやすい構成だった
旧形式の設定だけを唯一の原因と断定しないでください。
「旧形式の設定が残っていたことと、OpenCode側のモデル定義にコンテキスト上限が明示されていなかったことが、自動判定が期待どおり働かなかった有力な要因と考えられたため、両方を修正した」と理解しています。
FreeTokenとOpenCodeの役割
初心者にも分かりやすく、次の構成を整理します。
VM102
└─ OpenCode
  ├─ セッション管理
  ├─ モデル定義
  └─ 自動Compaction設定

Windows 11
└─ FreeToken
  ├─ Qwen3.6-35B-A3B-NVFP4
  └─ OpenAI互換API :1919
自動CompactionはFreeToken側の設定ではなく、OpenCode側の会話コンテキスト管理機能です。
設定する場所は、「FreeTokenを動かしているマシン」ではなく、「OpenCodeを実際に実行しているマシン」です。
今回の実例では、設定する場所はVM102です。
Windows側の次のファイルを変更しても、VM102上で実行しているOpenCodeには反映されません。
C:\Users\ユーザー名\.config\opencode\opencode.json
ただし、Windows上でもOpenCodeを実行している読者を否定しないでください。
一般論としては、「OpenCodeを実行しているマシンの設定ファイルを変更する」と説明しています。
Compactionとは
セッションが長くなるとモデルへ送るコンテキストが増えます。
モデルやランタイムの上限を超えると context_length_exceeded が発生します。
Compactionは、古いアクティブコンテキストをチェックポイント要約へ置き換える機能です。
ただし、いくつか注意点があります。
- 元のセッションメッセージが直ちに削除されるわけではない
- 以降のモデル呼び出しでは、チェックポイント要約と直近の履歴が使われる
- Compactionは要約なので完全に無損失ではない
- 重要な仕様や決定事項は、会話履歴だけに依存しない方が安全
重要な情報は、次のようなファイルにも残すことを推奨します。
- README
- AGENTS.md
- 作業記録
- 変更履歴
- TODO
- ロールバック手順
旧設定と修正後の設定
調査時のVM102では次の設定が入っていました。
"compaction": {
  "auto": true,
  "prune": true,
  "preserve_recent_tokens": 15000,
  "reserved": 20000
}
今回採用した形式は次です。
"compaction": {
  "auto": true,
  "keep": {
    "tokens": 15000
  },
  "buffer": 20000
}
設定キーの意味は次の通りです。
auto:自動Compactionの事前判定などを有効にするkeep.tokens:Compaction後にも保持する直近コンテキスト量の目安buffer:上限到達前に確保する安全余白
bufferを大きくすると、自動Compactionは一般に早めに開始されます。
今回は旧キーを、現在の公式例で使われる keep.tokens と buffer へ置き換えました。
旧キーがすべてのOpenCodeバージョンで必ず無効だった、と断定しないでください。
今回使用しているOpenCode 1.18.29の実環境では、公式ドキュメントに合わせて現行形式へ変更しています。
掲載する設定例
重要:この例だけで opencode.json 全体を上書きしないでください。
既存の permission、watcher、ほかのprovider、モデル、プラグイン設定などを残し、該当部分だけを追加または更新します。
関係部分だけの抜粋です。
{
  "model": "freetoken-main/Qwen3.6-35B-A3B-NVFP4",
  "provider": {
    "freetoken-main": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Main PC FreeToken",
      "options": {
        "baseURL": "http://192.168.0.128:1919/v1",
        "apiKey": "freetoken"
      },
      "models": {
        "Qwen3.6-35B-A3B-NVFP4": {
          "name": "Qwen3.6 35B A3B on RTX 3060",
          "limit": {
            "context": 184320,
            "output": 4096
          }
        }
      }
    }
  },
  "compaction": {
    "auto": true,
    "keep": {
      "tokens": 15000
    },
    "buffer": 20000
  }
}
apiKey の値「freetoken」は、公開してよいローカル用文字列です。
実際の秘密鍵や認証トークンは掲載していません。環境に応じて適切な値に変更してください。
184320の扱いについて
184320 は、今回のFreeToken環境がエラーメッセージで示した最大値です。
次の点に注意してください。
- モデルごとにコンテキスト上限は異なる
- FreeTokenの起動設定によって上限が異なる場合がある
- KVキャッシュ予算によって実上限が変わる場合がある
- モデルを変更した場合は値を再確認する
limit.contextを実際より大きくすると、OpenCodeの自動Compactionより先にFreeTokenが拒否する可能性があるlimit.contextを実際より小さくすると、必要以上に早くCompactionされる可能性があるlimit.outputもモデルと用途に合わせる必要がある- 記事の数値を別環境へそのままコピーしない
自動Compaction開始位置の概算
OpenCode公式ドキュメントでは、自動Compactionの判定に次の考え方が示されています。
estimated tokens >=
min(
  input limit - buffer,
  context limit - max(output reserve, buffer)
)
今回の設定例を単純化した概算として、次を計算します。
184320 - max(4096, 20000)
= 164320
OpenCodeが使用量を正しく把握できていれば、約 164,320 トークン付近から自動Compactionの対象となり、184,320 トークンの上限より約 20,000 トークン手前で処理が始まる見込みです。
ただし、これは保証値ではありません。
次の要因で実際のタイミングは前後します。
- OpenCodeのトークン推定
- APIレスポンスのusage情報
- システムプロンプト
- ツール定義
- ファイルの内容
- ツール実行結果
- 添付データ
- 出力予約
- 使用モデル
- OpenCodeのバージョン
- OpenAI互換APIの実装
「164,320 トークンで必ず発火する」と断定しないでください。
安全な設定手順
次の順序で設定を行ってください。
- OpenCodeを終了する
- OpenCodeを実行しているマシンへ接続する
- 設定ファイルの実在を確認する
- 日時付きバックアップを作成する
- 設定を編集する
- JSON構文を検証する
- 設定値を再読込して確認する
- OpenCodeを再起動する
- 長いセッションで自動Compactionを観察する
- 必要に応じてDEBUGログを確認する
バックアップ例
config="$HOME/.config/opencode/opencode.json"
backup="$config.bak-$(date +%Y%m%d-%H%M%S)"

cp -p "$config" "$backup" || exit 1

echo "Backup: $backup"
バックアップ作成に失敗した場合は、編集を続行しないでください。
JSON構文確認例
python3 -m json.tool \
  "$HOME/.config/opencode/opencode.json" \
  >/dev/null &&
  echo "OK: OpenCode JSON is valid"
OpenCodeの通常起動
opencode
DEBUGログ付き起動
opencode --log-level DEBUG
設定の上書きにも注意する
OpenCodeの設定は、複数の設定元から読み込まれる可能性があります。
グローバル設定を変更しても改善しない場合は、次を確認してください。
- プロジェクトディレクトリの
opencode.json OPENCODE_CONFIGOPENCODE_CONFIG_CONTENT.opencodeディレクトリ- 使用中プロジェクト固有の設定
- 起動方法によるインライン設定
- 実際に選択されているモデル名
プロジェクト設定などがグローバル設定と競合する場合、後から読み込まれる設定が競合キーを上書きする可能性があります。
ロールバック
問題が発生した場合は、OpenCodeを終了してからバックアップを復元できます。
バックアップ名は実行日時で変わるため、固定名として断定しないでください。
例:
cp -p \
  "$HOME/.config/opencode/opencode.json.bak-YYYYMMDD-HHMMSS" \
  "$HOME/.config/opencode/opencode.json"
復元後は次を確認してください。
- JSON構文を確認
- OpenCodeを再起動
- モデル接続を確認
- 必要に応じて
/compactでセッションを復旧
トラブル時の確認項目
設定後も自動Compactionが働かない場合は、次を確認してください。
- OpenCodeを再起動したか
- 設定したのがOpenCodeを実行しているマシンか
- 編集したファイルが実際に読み込まれているか
- プロジェクト設定で上書きされていないか
OPENCODE_CONFIGなどの環境変数がないか- モデル名が設定内のモデルIDと一致しているか
- FreeToken側の実上限が変わっていないか
- APIがusage情報を返しているか
- DEBUGログにcompactionやoverflowが記録されているか
context_length_exceededが先に発生していないか
緊急回避として、上限へ近づいた段階で手動 /compact を実行できることも覚えておいてください。
検証済み事項と未確認事項
確認済み
- VM102側の設定ファイルをバックアップした
opencode.jsonのCompaction設定を現行形式へ変更したlimit.context = 184320を追加したlimit.output = 4096を追加したcompaction.auto = trueを設定したcompaction.keep.tokens = 15000を設定したcompaction.buffer = 20000を設定した- JSON構文が正常であることを確認した
- 設定値を再読込して表示できた
最終確認中
- 長時間セッションで自動Compactionが実際に発火するか
- FreeTokenのusage情報をOpenCodeが正しく利用できるか
- 同じ
context_length_exceededが再発しないか
参考リンク
- OpenCode公式 Compaction: https://opencode.ai/v2/docs/compaction
- OpenCode公式 Config: https://opencode.ai/docs/config/
限界と注意点:量子化・RAM拡張・VRAM制限の実測値から
ロボ小職
| ポイント | 内容 |
|---|---|
| 速度 | 24Bで22 tok/s(物理PC)。VMではさらに遅くなる |
| メモリ不足リスク | VMのRAMが足りないとプロセスがキルされる |
| 発熱・消費電力 | GPUがフル稼働するため長時間運用は注意 |
| 並行稼働不可 | RAMを大量に使うため、他のアプリと並行は厳しい |
管理人の小職さん
Proxmoxサーバ(64GB RAM)でVM整理して、RTXをパススルーでLinuxVMに割り当てるのも一つの案。
でも、今の御時世としての楽しみ方としては、まずは手元の環境で試してみるのが一番。
RAM高騰前にこの革命的アプリがあったらフルにRAM積んでいたのに…という悔しさもありますけど。
ロボ小職

ロボ小職が教えるFreeToken実装のまとめ
管理人の小職さん
GPU 8GBでも35Bモデルが動くって、すごいね。
FreeTokenでRTX 3060 12GBの性能を限界まで引き出しました!
みなさんも、お手持ちのグラボでローカルLLMデビューしてみてくださいね。
グラボを使わないローカルLLM環境も知りたいという方は、LM Studioを使ったローカルLLM構築ガイドも合わせてご覧ください。
「どのモデルがいいかわからない」という方は、ぜひコメントで質問してください!
ロボ小職
FreeTokenのポイント
・FreeTokenなら、GPU 8GBのPCでも24Bモデルが「遅いけど動く」
・VMのRAMを活用すれば、さらに大きなモデルが試せる
・バイブコーディングには十分使える(コーヒー飲みながら待てる速度)
・毎日の開発ツールとしては35B以下がおすすめ
感動のポイント
・RTX 3060 12GB単体で、ローカルでは動作不可だったLLMが動作する
・これまでMacMini 32GB RAMくらいでしか楽しめなかったのが、Windows環境でも
・動的RAM利用が革命的
📋 投稿の解説:管理人の小職さんが実際にFreeTokenを使った体験談です。クラウドAIが使えないタイミングでも、RTX 3060 12GB + RAM 32GBの環境でFreeTokenを使えば、_RAM 48GB相当のMac mini並みの動作が実現できるそうです。長時間のタスクでも投げ出されず完遂できたとのことで、ローカルLLMの実用性を実感できる貴重な報告です。
「試してみたい」人はまずFreeTokenで遊んでみてください。
PC Watchでも紹介されている注目のプロジェクトです!
参考
PC Watch: 8GBのGPUで35Bモデルが高速動作!MoE特化の実行環境『FreeToken』
参考
関連記事:ゲーム以外でグラボを酷使!ローカルLLM環境を構築してLM Studioで遊んでみた
あわせて読みたい
FreeTokenでローカルLLMを楽しんだら、次に試してみたい記事はこちらです。
- ローカルLLM向けグラボの選び方2026|RTX・Radeon・Arc全比較&おすすめ — GPU選びの基礎知識とコストパフォーマンス
- FreeToken-Pascalで古いGTX 1070でもQwen3.6 35Bが動作!llama.cpp常用環境の実装記録 — 中古GPUでローカルLLM構築
- ゲーム以外でグラボを酷使!ローカルLLM環境を構築してLM Studioで遊んでみた — LM Studioを使った初心者向け入門
管理人の小職さんも、FreeTokenの可能性にすっかり興味を持ったようです。
次の実験は「ProxmoxサーバにRTX 3060を積んで、パススルーでVMに割り当てる」かもしれませんw
読者のみなさんも、まずはFreeTokenをダウンロードして、自宅AIとの会話を楽しんでみてください。
RECOMMENDED
━━━ こちらもチェック! ━━━
omoiji.com では他にも様々なコンテンツを公開中です!ぜひご覧ください!
(PR)



タグ