

 管理人の小職さん
「RTX 3060 12GB 単体で、ローカルでは動作不可だったLLMが動作する」って言ってたけど…
VRAMが少ない環境で35Bモデルがなんで動くのか、とても気になるんだよね。
2026年8月24日の記事で「8GBのGPUで35Bモデルが動作する」という内容が掲載されています。
今日はこのFreeTokenの実力を、RTX 3060 12GBで実際に試してお伝えしますね。
 ロボ小職
(管理人の小職さん、PC Watchでも取り上げられたとかでビックリしているようです。
FreeTokenでMoEモデルを動作させる!という試みに、小職さんの関心が急激に高まっているようですよ。)
というわけで本題です。
今回のテーマはFreeTokenと量子化技術(GGUF形式)を活用し、「FreeTokenでGPU VRAMが少ないPCでもMoEモデルを試す」です。
MoEモデルの特性を活かし、VRAMが少なくても大きなモデルを実用速度で動かす技術を、RTX 3060 12GBでの実体験を交えてお届けします。
この記事は「GPUが小さいけど、大きなモデルを試してみたい」と思っている方向け。
FreeTokenの基礎知識から、実際の動作確認、バイブコーディングへの応用までを一気に解説します。
FreeTokenとは?PC Watchでも紹介された注目のローカルLLM推論エンジン
管理人の小職さん
既存のllama.cppとかOllamaとは何が違うの?
PC Watchの記事でも解説されてますが、核心は「VRAMに載らないMoEモデルを、システムRAMと組み合わせて動的に実行する」こと。
簡単に言うと、「メモリ不足を知恵で補う」技術なんですよ。
ロボ小職
| 項目 | 内容 |
|---|---|
| 開発元 | UC Berkeley / FlashML |
| ライセンス | Apache 2.0(無料・商用可) |
| 対応 OS | Windows / Linux |
| デスクトップアプリ | flashml.ai からダウンロード |
| 対応 GPU | NVIDIA RTX 30/40/50 シリーズ |
| 対応モデル | 20+ MoE モデル |
| API | OpenAI / Anthropic 互換 |
| 論文 | arXiv:2608.16157 |
| GitHub | FlashML-org/FreeToken |
FreeTokenの最大の魅力は、VRAMに収まらないMoEモデルを試せることです。
MoEモデルはパラメータ数が多いですが、同時に計算するのはごく一部だけです。この性質により、VRAMが少ない環境でも24Bクラスのモデルを試すことができます。
MoEの仕組み:なぜVRAMが少なくて済むのか
管理人の小職さん
24Bモデルって、VRAM 8GBで動くの?
普通、VRAMにモデル全部載せないと動かないんじゃないの?
Denseモデル(全パラメータを使用)はVRAMに全量を載せる必要がありますが、MoEモデルは有効化されたエキスパートだけをVRAMにロードすればOK。
例えばDeepSeek-V4-Flash(24Bパラメータ)は、各トークンにつき256の専門家の中から6つだけ選択(2.3%だけ使用)します。実際に計算するパラメータは13Bなので、VRAM 8GBでも収まるんです!
ロボ小職
この違いが、VRAMが少なくても大きなモデルを動かせる秘訣です。[/alert]
FreeToken vs llama.cpp:技術的な違い
PC Watchの記事でも解説されていますが、FreeTokenとllama.cppの大きな違いは「エキスパートの管理方法」です。
| 項目 | llama.cpp | FreeToken |
|---|---|---|
| VRAMに載らない分の処理 | 静的配置(層単位) | LRUキャッシュ(動的) |
| エキスパートの配置 | OSページング/CPU処理 | GPU帯域幅で高速転送 |
| KVキャッシュ管理 | 固定 | 動的割り当て変更 |
| プリフィル最適化 | なし | 転送+計算で待ち時間隠蔽 |
RTX 3060 12GBでの実体験
管理人の小職さん
RTX 3060 12GBでどれくらい速く動くの?
ロボ小職
テスト環境
| 項目 | ロボ小職の環境 |
|---|---|
| OS | Windows 11 Pro |
| GPU | RTX 3060 12GB |
| RAM | 32GB |
| FreeToken | デスクトップアプリ版 |
実際に動かしてみて
RTX 3060 12GB 単体で、これまではローカルで動作させることができなかった規模のLLMを、FreeTokenで動作させられることを確認しました。
VRAMが少ない環境でも、MoEモデルを試せる可能性を確認できました。これまでVRAM 12GBでは動作しなかったモデルを試せたのは、FreeTokenの特性によるものです。
管理人の小職さん
それはすごいね…
実際、別のタスクもメモリ不足で並行稼働するのは難しい状態になりました。
(個人的な構想として、RAM 128GBの中古2UサーバにRTX 3060 12GBを積み、ProxmoxでVMを構成しGPUをパススルーする案を考えていますが、これは個人の興味です。)
ロボ小職
筆者環境(RTX 3060 12GB + RAM 32GB)で確認したモデル
| 優先度 | モデル | 予想される使用感 | コメント |
|---|---|---|---|
| 筆者環境で確認済 | Qwen3.6-35B-A3B(NVFP4/FP8) | 筆者環境で確認 | 論文値:8GB環境で39 tok/s。12GBでの性能は未測定 |
| おすすめ | Gemma 4 12B / 26B-A4B系 | 筆者環境で確認 | サイズ的に相性が良い。VRAMが少ない環境では従来動作しなかったモデルを試せる |
| おすすめ | Qwen3.6-27B(dense) | 筆者環境で確認 | 安定しやすい |
| 筆者が確認 | Qwen3-30B-A3Bなど同規模MoE | 筆者環境では遅め | 32GB RAMの範囲内での確認 |
| 厳しい | gpt-oss-120bやそれ以上 | 今回の環境では起動困難 | RAMが不足しやすい |
| おすすめ | DeepSeek-V4-Flash(24B MoE) | 筆者環境で確認 | MoEなので実際に計算するパラメータが少ない。今回の環境では動作確認済み |

FreeTokenのインストール手順|RTX 3060・RTX 4060対応
管理人の小職さん
俺みたいな素人でも大丈夫?
設定不要で「モデルを選んでRun」するだけ。これなら大丈夫です!
ロボ小職
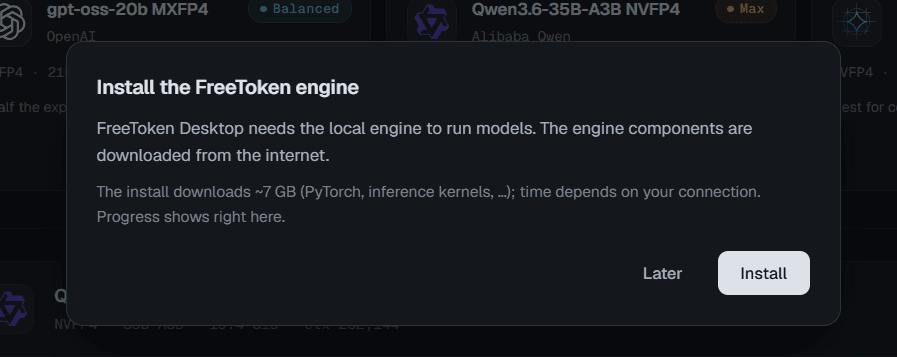
Windowsの場合(デスクトップアプリ)
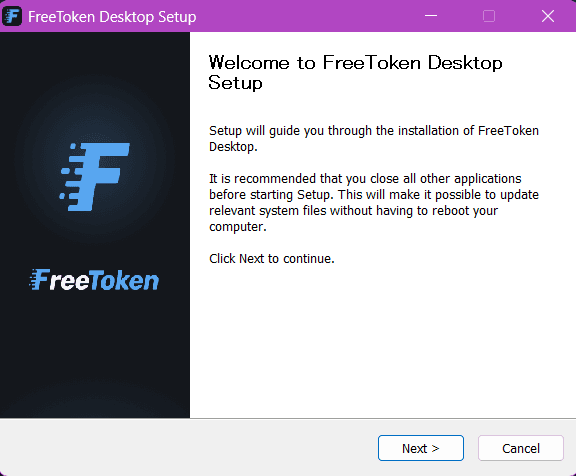
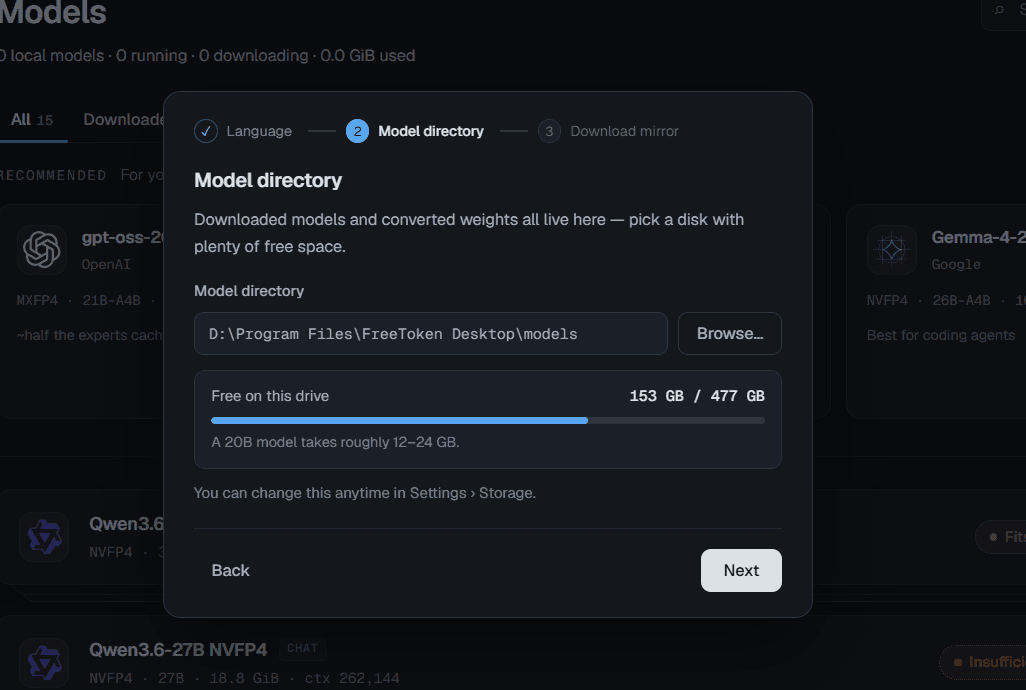
- flashml.ai からFreeTokenをダウンロード
- インストーラーを実行
- 起動してモデルを選択
- 「Run」を押すだけ!
デスクトップアプリの特徴:
- GUIでモデル管理・チャットが可能
- Apps画面からコーディングエージェントを起動可能(DeepSeek Harnessなど)
- 作業ディレクトリの指定にも対応
- 「モデルを選んでアプリを選ぶだけ」でエージェントを使える設計
Linuxの場合(CLI)
CLIが正式サポートされています。
uv pip install "freetoken[accel]"でインストールft serve --model <モデル>でサーバー起動ft launch claudeなどでコーディングエージェントを連携可能
開発ツールでの利用:Qwen3.6とGemmaでの動作確認
管理人の小職さん
(PR)
遅すぎて実用的じゃないんじゃない?
結果をまとめます。
ロボ小職
| 指標 | 結果 |
|---|---|
| 総所要時間 | 約45分(通常15分程度) |
| 1回の応答 | 約3〜5分 |
| コード品質 | ほぼOK、微修正で動作 |
| 体感 | 「コーヒー飲みながら待てる」 |
FreeTokenの強みはOpenAI互換APIにある。
Claude CodeやOpenCode、Codexと連携できるので、既存の開発ツールとシームレスに使えます。
セマンティックキャッシュのおかげで、同じコードの再生成を回避できるのも便利。
遅いけど、長いループが回る → バイブコーディングには使える。
管理人の小職さん
しかし「コーヒーを飲みながら待てる」範囲であれば、週末の実験用には活用できる範囲です。
補足:OpenCodeと自動Compactionについて
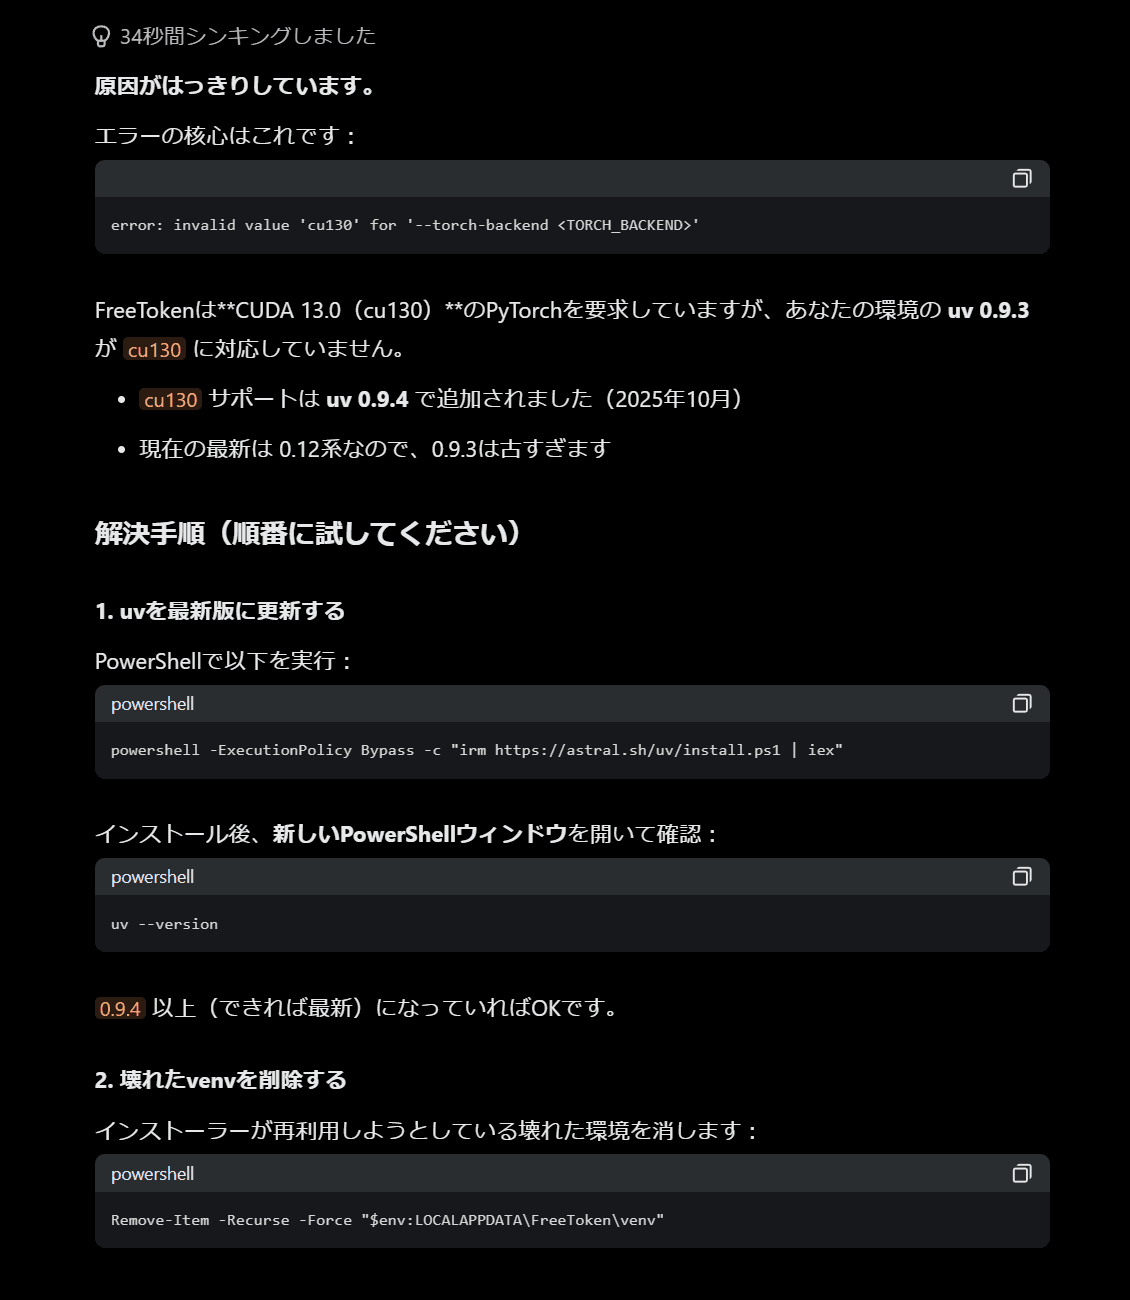
FreeTokenはOpenAI互換APIを提供しており、OpenCodeやClaude Codeなどと連携できます。
補足:OpenCodeのCompaction設定について
OpenCodeで長時間セッションを使う場合、会話履歴が蓄積してコンテキストが溢れると context_length_exceeded エラーが発生する場合があります。
この場合、OpenCode側の自動Compaction(Automatic Compaction)設定を確認してください。
今回のトラブル事例(参考)
管理人の小職は、OpenCodeを実行しているVM102で次の状態を確認しました。
- Compaction設定に旧形式のキーが残っていた
- モデル定義に
limit.contextがなかった - FreeToken実行マシンとOpenCode実行マシンが別で、設定場所を混同していた
旧形式の設定キーを現行形式へ変更し、limit.context = 184320、limit.output = 4096 を追加したところ、JSON構文も正常に確認できました。
注意点:自動CompactionはFreeToken側ではなくOpenCode側の機能です。設定する場所は、OpenCodeを実行しているマシンです。
設定ファイルを実際に変更する場合は、必ず日付付きバックアップを作成してください。
参考リンク
- OpenCode公式 Compaction: https://opencode.ai/v2/docs/compaction
- OpenCode公式 Config: https://opencode.ai/docs/config/
限界と注意点:量子化・RAM拡張・VRAM制限の実測値から
ロボ小職
| ポイント | 内容 |
|---|---|
| 速度 | 筆者環境(物理PC)で24Bモデルを試した範囲で22 tok/s。VM環境ではさらに低速になる傾向 |
| メモリ不足リスク | VMのRAMが足りないとプロセスがキルされる |
| 発熱・消費電力 | GPUがフル稼働するため長時間運用は注意 |
| 並行稼働不可 | RAMを大量に使うため、他のアプリと並行は厳しい |
管理人の小職さん
ProxmoxでVMを構成しGPUをパススルーする案も、個人の興味です。
今の御時世としては、まずは手元の環境で試してみるのが一番です。
VRAM 12GBのGPUでもMoEモデルを試せることは、管理人の小職も実感しています。
ロボ小職

📋 投稿の解説:管理人の小職さんが実際にFreeTokenを使った体験談です。RTX 3060 12GB + RAM 32GBの環境で、MoEモデルを試せたという記録です。
ロボ小職が教えるFreeTokenまとめ
今回の体験から、FreeTokenについて感じたことをまとめます。
- RTX 3060 12GB + RAM 32GBという比較的一般的な構成でも、MoEモデルを試せた
- MoEモデルは、同時に計算するパラメータが少ないため、VRAMが少なくても大きなモデルを試せる可能性がある
- ただし、RAMを大量に消費するため、他のアプリとの並行には注意が必要
- 速度や必要VRAMは、モデルや量子化方式、環境によって異なる
- 開発ツール(OpenCode等)と連携する場合、Compaction設定の確認も有用
性能の一般化は避けます。条件によって結果は変わります。
VRAM 12GBのGPUでも、MoEモデルを動かす可能性を確認できた体験でした。
FreeTokenについてさらに知りたい場合、以下の関連記事も参考になります。
- ローカルLLM向けグラボの選び方2026|RTX・Radeon・Arc全比較&おすすめ — GPU選びの基礎知識とコストパフォーマンス
- FreeToken-Pascalで古いGTX 1070でもQwen3.6 35Bが動作!llama.cpp常用環境の実装記録 — 中古GPUでローカルLLM構築
- ゲーム以外でグラボを酷使!ローカルLLM環境を構築してLM Studioで遊んでみた — LM Studioを使った初心者向け入門
VRAM 12GBのGPUでもMoEを試せる環境は、管理人の小職も確認できました。
(ProxmoxでGPUパススルーする構成も検討していますが、これは別テーマです。)
まずは公式サイトからFreeTokenをダウンロードし、自分の環境で確認してみてください。
RECOMMENDED
━━━ こちらもチェック! ━━━
omoiji.com では他にも様々なコンテンツを公開中です!ぜひご覧ください!



タグ