 管理人の小職さん
 ロボ小職
「ローカルLLM」で検索して、モデル名の一覧だけが延々と並ぶ記事にたどり着いて、そっと閉じたことはないだろうか。
2026年に入って、この分野は半年で景色が変わった。主流は「大きいモデルを1つ持つ」から「MoE(専門家の分業)で必要な所だけ動かす」へ移り、量子化は4bitが前提、投機デコード(MTP)も実用段階に入っている。おかげで、ちょっと前なら「動かすにはサーバーが必要」だった規模のモデルが、24GBクラスのGPUに乗るようになった。
ところが、多くの比較記事はまだ「7B・13B・70B」というdense時代の区切りで語っている。MoEだと総パラメータが35Bでも、実際に動くのは3Bぶんだ。この違いを押さえないと、「自分のPCで動くのか動かないのか」はいつまでも分からないままになる。
この記事では、2026年9月時点で話題の新しいモデルを6つに絞り、次の4点だけに集中して解説する。
- 動くのか — VRAMと量子化別の、実際のファイルサイズで
- 日本語で使えるのか — 日本語ベンチの実測値を、正しい読み方で
- 商用で使えるのか — 2026年8月のライセンス改定まで反映して
- 何に向くのか — 汎用・コーディング・長文脈・軽量
そしてこの記事では、実際に手元のマシンで動かした結果を載せる。RTX 3060 12GB という、いちばん多くの人が持っている12GB帯で、Gemma 4 12B と gpt-oss-20b の tok/s と VRAM 実使用量を測ってみた。逆に、12GBでは現実的でないモデルは「動かしていない」と正直に書く。スペックのコピーを実測のように見せることはしない。
読み終わる頃には、「自分の環境ではどれを入れて、どれを諦めればいいか」が分かるはずだ。
2026年のローカルLLMは、ここが変わった
まず大前提を3つだけ押さえておこう。この3つを知らないと、2026年のモデル選定は必ずつまずく。
MoE(専門家の分業)で「大きいのに軽い」が当たり前になった
MoE(Mixture of Experts)は、パラメータを複数の「専門家」に分け、質問のたびに必要な専門家数だけを起動する構造だ。たとえば Qwen3.6-35B-A3B は総パラメータ35Bを積みながら、実際に計算するのは Active 3B ぶんだけ。つまり「記憶量は35B級、頭の回転は3B級」という、従来になかった組み合わせになる。
結果として、VRAM 24GBクラスで35B級の知識量を扱えるようになった。従来なら70B級を動かすにはVRAM 40GB超が必要だったから、個人PCの常識が変わった。
4bit量子化が前提になった
量子化は、モデルの重みを fp16(16bit)から 4bit に詰め込む技術。VRAM要件はおよそ半分になり、品質の落ち方も実用上は小さくて済むようになった。2026年現在は「4bitで入れるのが基本戦」で、これはもう研究者の趣味ではなく一般化した運用だ。
さらに今年は QAT(Quantization Aware Training)が注目されている。通常の量子化は学習済みモデルを後から圧縮するが、QATは4bitで使うことを前提に再学習するため、同サイズでも品質が落ちにくい。今回実測する Gemma 4 12B にもQAT版があり、同梱の4bit版より速いケースすらある。
投機デコード(MTP)で推論が速くなった
投機デコードは、「次の一言を先に予測して、当たっていればまとめて採用する」高速化技術だ。2025年頃は論文の話だったが、2026年夏時点では同梱のMTP(Multi-Token Prediction)が実用速度に寄与している。同じモデル・同じ量子化でも、エンジンがMTPを使えるかどうかで体感速度が変わる時代になった。
この3つが揃った結果、「総パラメータの大きさ」ではなく「実ファイルサイズとActive量」でモデルを見る必要が生じた。次の早見表は、その基準で並べている。
この記事の選定基準
話題のモデルは無数にあるが、ここでは6つに絞る。絞り込み条件は次の5つだ。
- 新しめ — 2026年公開・大幅更新のモデルを選ぶ
- 日本語実用圏 — 日本語ベンチで優良な実績があること
- 現実的に動く — 単体PC〜小型サーバで回るサイズであること
- ライセンスが明確 — 商用可否が一次情報で読めること
- VRAM帯が重複しない — 8GB〜128GBを1枚の地図としてカバー
この記事では「実測したモデル」と「スペックの紹介だけ」を明確に分けるよ。RTX 3060 12GB で動かせたのは Gemma 4 12B(QAT)と gpt-oss-20b の2つ。それ以外の4モデルは、動かしていないので動かしていないと書く。数字を見せるだけの紹介と混同しないでね。
早見表:まずはここだけ見ればOK
細かい説明は後回しにして、まず結論の3表を並べる。自分のVRAMに近い帯を探して、その行のモデルを最初の候補にすれば間違いない。
管理人の小職さん
ロボ小職
VRAM帯別「動くモデル」
| メモリ帯 | 代表ハード | 動く6モデル |
|---|---|---|
| 8GB | RTX 4060 / 中古GPU | gpt-oss-20b(Q3以下)・Gemma 4 12B(Q4・やや厳しい) |
| 12GB | RTX 3060 12GB(この記事の実測機) | Gemma 4 12B(QAT)・gpt-oss-20b(Q4可) |
| 16GB | RTX 5060 Ti / M4 16GB | gpt-oss-20b(快適)・Gemma 4 12B(余裕) |
| 24GB | 中古RTX 3090 / 4090 | Gemma 4 26B-A4B(17GB)・Qwen3.6-35B-A3B(22GB・ぎりぎり) |
| 32GB | RTX 5090 | Qwen3.6-35B-A3B(快適) |
| 128GB統合 | Strix Halo / DGX Spark | DeepSeek V4 Flash(3bit・約104GB)・GLM-5.3-Flash |
量子化別の実サイズ(総パラメータとActive量)
MoEモデルは「総量」と「実際に動く量」が違う。この2つを分けて覚えないと、VRAMの計算を間違える。
| モデル | 総量 / Active | 4bit等の実サイズ | 備考 |
|---|---|---|---|
| Gemma 4 12B(QAT) | 12B / 12B(dense) | 約7.0GB(実測) | 12GBに完全に載る |
| gpt-oss-20b | 21B / 3.6B(MoE) | 約13GB(実測) | 12GBではCPUへ一部溢れる |
| Gemma 4 26B-A4B | 25.2B / 3.8B(MoE) | 約17GB | 24GB帯の定番 |
| Qwen3.6-35B-A3B | 35B / 3B(MoE) | 約22GB | 24GBはぎりぎり・32GB推奨 |
| GLM-5.3-Flash | 320B / 18B(MoE) | —(実測せず) | 128GB統合メモリ級が現実的 |
| DeepSeek V4 Flash | 284B / 13B(MoE) | 約104GB(3bit) | 同上・128GB単機が前提 |
日本語性能(総合と日本固有知識は別物)
| 順位 | モデル | Shaberi3 総合 | JamC-QA(日本知識) |
|---|---|---|---|
| 1 | DeepSeek-V4-Flash | 0.8269 | 63.92%(首位) |
| 2 | Qwen3.6-35B-A3B | 0.8186 | 55.26% |
| 3 | Gemma4-31B | 0.8133 | 61.28% |
| 6 | Gemma4-26B-A4B | 0.8076 | 58.08% |
| 8 | GLM-5.2 | 0.7904 | — |
総合の上位6モデルは 0.0193 の幅しか離れていない。つまり「総合1位だから最強」ではなく、差が出るのは日本固有知識とタスク別のサブセットだ。この点は後段「日本語性能の正しい読み方」で詳しく解説する。
ライセンス早見
2026年8月、Alibaba と Z.ai が主力の最上位モデルだけ独自ライセンスへ移行した。旧記事の「QwenはApache、GLMはMIT」だけを信じていると、商用前提の選定が後から崩れる。
| ライセンス | 該当モデル | 商用利用 |
|---|---|---|
| Apache 2.0 | Qwen3.6-35B-A3B / Gemma 4 26B-A4B / Gemma 4 12B / gpt-oss-20b | 自由(無制限) |
| MIT | GLM-5.3-Flash / DeepSeek V4 Flash | 自由(無制限) |
| 独自(参考) | GLM-5.3本体・Kimi K3・Qwen3.8-Max | 条件付き(収益ゲート等) |
この記事で紹介する6モデルはすべて Apache 2.0 か MITで、商用利用に制限はない。ただし必ず一次情報(Hugging Face の LICENSE)で再確認してほしい。ライセンスは改定されることがあるのだ。
モデル① Qwen3.6-35B-A3B:日本語・速度の本命
1つ目は、2026年夏時点の第一候補といえる Qwen3.6-35B-A3B。Alibaba(Qwen)が開発した、日本語・速度・品質の三拍子が揃ったモデルだ。
(PR)
| 項目 | 内容 |
|---|---|
| 規模 | 総35B / Active 3B(MoE・hybrid attention) |
| ライセンス | Apache 2.0(商用可・制限なし) |
| コンテキスト | 262K(YaRNで1M拡張可) |
| 対応 | テキスト+画像+動画 |
| 4bitでのサイズ | MXFP4_MOEで約22GB |
| 日本語性能 | Shaberi3 0.8186(8モデル中2位) |
| 参考速度 | 単機96.2 tok/s(DGX Spark実測・出典は末尾) |
何がすごいのかというと、Active 3B という一点だ。22GB を VRAM に載せてしまえば、頭の回転は3Bモデルと同じくらい軽い。だから24〜32GB級のGPUでも実用速度が出る。日本語ベンチは総合2位で、日常用途の日本語なら上位モデルとの差はほとんど分からない。
向く人:24〜32GBのGPUを持ち、日本語で汎用的に使いたい人。向かない人:VRAM 12GBの人。実測はしていないが、22GBは12GBでは載らないため、部分オフロードならCPU RAMに頼ることになり速度は大きく落ちる。12GB帯で無理に動かすなら、次の Gemma 4 12B を試したほうが合理的だ。
GPUの枠に空きがあって一台増やすなら、24GB帯が現実的な選択になる。中古でも相場が落ちてきたRTX 3090系が定番だ。
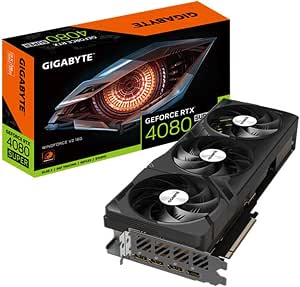

24GBあれば Gemma 4 26B-A4B(17GB)は快適に、Qwen3.6-35B-A3B(22GB)も4bitなら載る。ローカルLLM用にGPUを選び直す際の考え方については、ローカルLLM向けグラボの選び方2026 に詳しい。
モデル② Gemma 4 26B-A4B:24GB帯の優等生
2つ目は Google の Gemma 4 26B-A4B。総25.2B・Active 3.8B のMoEで、4bit量子化(UD-Q4_K_M)なら約17GBと、24GBのGPUに余裕で収まる。
| 項目 | 内容 |
|---|---|
| 開発 | |
| 規模 | 総25.2B / Active 3.8B(MoE 128e・8 active) |
| ライセンス | Apache 2.0(Gemma 3 の独自契約は撤廃) |
| コンテキスト | 256K |
| 4bitでのサイズ | 約17GB |
| 日本語 | Shaberi3 0.8076 / JamC-QA 58.08% |
| 特記 | rakuda-questions(日本知識)で首位 0.8975、428B級を上回る |
注目してほしいのが rakuda-questions での首位だ。日本の地理・歴史・文化に関する質問で、総パラメータ428B級の巨大モデルを26Bが上回った。これは「大きいモデル=日本語が強い」という思い込みへの反例そのものだ。日本固有知識の多さはパラメータ量ではなく、学習データの質で決まる。
弱点も正直に書くと、tengu_bench(総合難タスク)では 0.7522 と下位。難しい推論を長々と要求されるタスクは苦手だ。「日本語の知識を答えてもらう」用途では優等生、「複雑な業務ロジックを解く」用途では下位に回る。
17GBは24GB帯なら余裕があり、残りのVRAMはKVキャッシュ(会話の履歴管理)に使える。長い会話や長文読解をさせるなら、この「余白」がそのまま体感品質になる。
モデル③ Gemma 4 12B(QAT):12GB帯の入門にして本命
3つ目が、この記事の主役の1つ、Gemma 4 12B のQAT版だ。RTX 3060 12GB クラスで現実的に動くことを、今回実機で確かめた。
管理人の小職さん
ロボ小職
RTX 3060 12GB での実測結果
計測条件はこうだ。日本語プロンプト72字(「800字で日本語で詳しく説明」の指示)、thinking無効(–think false)、4回実行してRun1(初回ロード・キャッシュ影響)を除外した3回平均。VRAMは ollama ps のロード値。
| モデル | 実測tok/s | 最小〜最大 | TTFT | 出力 | メモリ配置 |
|---|---|---|---|---|---|
| Gemma 4 12B QAT(gemma4:12b-it-qat) | 33.77 | 33.44〜33.95 | 88.1ms | 58tok | 100% GPU(7.7GB) |
| gpt-oss 20b(gpt-oss:20b) | 19.94 | 18.36〜21.84 | 141.6ms | 115tok | 24% CPU / 76% GPU(14GB) |
QAT版のポイントは、モデルファイルが 7.0GB+プロジェクト175MB しかないこと。11.9B(Q4_0)なので12GBのVRAMに完全に載って、CPU RAMに溢れない。これが33 tok/s を安定して出せる理由だ。
ただし率直に言うと、33 tok/s は「読みながら待てる」速度。長い文章を一気に生成したい場合の体感ではない。800字の指示に対して実際の出力は58トークン(約150字相当)にとどまったので、「長文生成時の実体感とは異なる」こともお断りしておく。短い質問応答・要約・分類なら快適だが、長編の創作には向かない。
12GB帯でグラボを見直すなら、この帯で選択肢に入るモデルが何個あるかを知っておくと買いが外れない。12GB帯の選び方はローカルLLM推論環境比較2026 でも実測しているので、エンジン側の違い(Ollama / LM Studio / FreeToken)も合わせて確認してほしい。
RTX 3060 12GB は、ローカルLLM用として今も手堅い選択だ。自作なら単体で収まり、電源も650W前後で足りる。

なお QAT 版と通常の同梱4bit版は別物だ。Ollama では gemma4:12b-it-qat のようにタグで指定する。実際にどちらが速いかは環境依存だが、今回の実測ではQAT版が100% GPU搭載を実現している。
モデル④ gpt-oss-20b:軽量・安定の定番
4つ目は OpenAI の gpt-oss-20b。2025年8月公開のまま後継が出ていないが、今も「16GB帯の定番」として手放せない。総21B・Active 3.6B のMoEで、ネイティブMXFP4量子化により約13GB。
| 項目 | 内容 |
|---|---|
| 開発 | OpenAI |
| 規模 | 総21B / Active 3.6B(MoE・native MXFP4) |
| ライセンス | Apache 2.0(利用ポリシー併記) |
| コンテキスト | 128K |
| 実測サイズ | 約13GB・ロード時14GB |
| 特記 | ローカルjudgeとしても優秀(日本語ベンチの採点役に使われる例あり) |
先ほどの実測表にもあるとおり、RTX 3060 12GB では 14GB のロードが VRAM を超過し、24% が CPU へ溢れて 19.94 tok/s になった。Gemma 4 12B の 33.77 と比べて約41%の速度低下だ。「12GBで動く/動かない」は、モデルの実ファイルサイズでこれほど正確に分かれる。この2モデルの比較が、その境界をそのまま示している。
興味深いことに TTFT(初回応答までの時間)は Gemma 88.1ms / gpt-oss 141.6ms とさほど差がなく、違いは継続生成速度に出る。「即答してくるが遅く出る」のではなく、「最初は同じ速さなのに、書き続けたときに差が開く」という現象だ。
用途としては、判断・分類・要約・ローカルjudge(採点役)に向く。日本語の知識量は大型モデルに劣るので、「日本語の雑学を答える」用途では Gemma 4 や Qwen のほうが向いている。判断タスクを大量に流す用途なら、VRAMに余裕がある16GB帯で入れておくと使いやすい。
モデル⑤ GLM-5.3-Flash:コーディング・エージェント枠
このモデルは今回実測していない。総320Bというサイズで、RTX 3060 12GB では現実的に動かせないため、スペックと出典だけを紹介する。動かしたかのような書き方はしない。
| 項目 | 内容 |
|---|---|
| 開発 | Z.ai(Zhipu) |
| 規模 | 総320B / Active 18B(MoE 288e・hybrid sparse + linear attention) |
| ライセンス | MIT(Flashのみ。上位GLM-5.3は独自ライセンス+収益ゲート) |
| コンテキスト | 1M |
| 参考ベンチ | SWE-bench Pro 62.1 / Terminal-Bench 2.1 81.0 |
| 参考 | Artificial Analysis Intelligence Index(2026-09-08)でオープン最高45 |
強みはコーディングとツール呼び出し(エージェント動作)だ。コードを書いて、ターミナルを叩いて、結果を見てまた書く、という反復が得意。Flash は MIT なので商用も自由。ただし320Bクラスなので、動かすなら128GB統合メモリ級(Strix Halo や DGX Spark)が現実的な枠に入る。日本語の総合力は Qwen / Gemma に譲る(Shaberi3 で GLM-5.2 は 0.7904 と下位)。
つまり「コーディング特化で、日本語はそこそこ」な枠だ。日本語の対話が主用途なら候補から外していい。
モデル⑥ DeepSeek V4 Flash:長文脈・日本知識の首位
これも今回実測していない。3bit量子化でも約104GBと、12GB機では1ミリも動かない。スペックと出典のみを記載する。
| 項目 | 内容 |
|---|---|
| 開発 | DeepSeek |
| 規模 | 総284B / Active 13B(MoE 256e + sparse attention) |
| ライセンス | MIT |
| コンテキスト | 1M |
| 量子化別サイズ | 3bitで約104GB(128GB単機で動作実績あり) |
| 日本語 | Shaberi3 0.8269(総合1位) / JamC-QA 63.92%(首位) |
| 参考速度 | 単機3bitで30.7 tok/s |
日本語ベンチは総合首位、日本固有知識(文化・地理・歴史)も首位。100万トークンの文脈を持つので、長文書を丸ごと読ませる用途では最強クラスだ。問題はサイズで、量子化しても100GBを超える。個人が手元で動かすなら、128GB統合メモリ機(Strix Halo / DGX Spark)以上が前提になる。
「日本語なら結局これ」と思うかもしれないが、注意も必要だ。総合1位でも、日常の短い質問応答では上位6モデルの差(0.0193幅)は体感できない。100GB超のメモリと電力を背負ってでも、その差が欲しいタスクがあるのかを先に考えたい。
VRAM別の選び方
6モデルを知ったところで、「自分の環境ならどれ」に落とし込む。帯ごとの最初の一手を示す。
帯別の「最初に入れるならこれ」
| VRAM | 最初に入れる | 次に検討する |
|---|---|---|
| 8GB | gpt-oss-20b(Q3以下) | Gemma 4 12B(Q4・辛い場合はRAM増設) |
| 12GB | Gemma 4 12B(QAT) — 実測33.77 tok/s | gpt-oss-20b(実測19.94・CPU溢れあり) |
| 16GB | gpt-oss-20b(完全にGPU搭載へ) | Gemma 4 12B(余裕) |
| 24GB | Gemma 4 26B-A4B(17GB) | Qwen3.6-35B-A3B(22GB・ぎりぎり) |
| 32GB | Qwen3.6-35B-A3B | Gemma 4 31B |
| 128GB統合 | DeepSeek V4 Flash(3bit) | GLM-5.3-Flash(コーディング用途) |
12GB帯はこの記事の実測がある。Gemma 4 12B(QAT)が VRAM に完全搭載されて 33.77 tok/s、gpt-oss-20b は 24% が CPU に溢れて 19.94 tok/s。どちらも「動く」が、体感は1.7倍違う。迷ったら Gemma 4 12B(QAT)から入るのが12GB帯の正解だ。
3問で決まる判断フロー
細かい比較をする前に、3つに答えてほしい。
- ① 何をしたい? — 汎用なら Gemma / Qwen、コーディングなら GLM、長文脈なら DeepSeek
- ② VRAM は何GB? — 12GBなら Gemma 4 12B(QAT)と gpt-oss-20b の2択まで絞れる
- ③ 日本語の知識は重視? — 重視なら JamC-QA(日本固有知識)の順位を見る
この3問に答えるだけで、6つの候補は1〜2個に収束する。RAM が余っている人は、VRAM に載せきれない部分を RAM で受け持つ構成(FreeToken や llama.cpp のオフロード)も選択肢になる。実際、RTX 3060 12GB + RAM 32GB で大型 MoE を動かす構成の記録はRTX 3060 12GB + 32GB RAM での実践記録にまとめている。
メモリは先に厚くしておくほど有利だ。モデルのロード・KVキャッシュ・OS動作すべてに関わる。

DDR5 対応か DDR4 対応か、スロットは何個あるかは、購入前にマザーボードの確認が必須だ。古い機械をローカルLLM用に生かす場合は、古いGPU(GTX 1070系)でも大型モデルを動かすような、RAM と CPU を組み合わせるアプローチも参考になる。
日本語性能の正しい読み方
管理人の小職さん
ロボ小職
総合点の差は、実用上ほぼ誤差
Shaberi3 の総合点(overall_norm)で見ると、上位6モデルは 0.0193 の幅に収まっている。平均的な質問でこの差を体感するのは難しい。総合点の順位だけでモデルを選ぶと、「1位と6位を比べて実差はなかった」ことになりかねない。
差が出るのは「日本固有知識」と「難易度別」
JamC-QA は日本の文化・地理・歴史・社会に関する固有知識を問う。ここでは DeepSeek V4 Flash が 63.92% で首位、Gemma4-31B が 61.28%、Gemma 4 26B-A4B が 58.08% と、総合順位とは違う並びになる。日本の制度や地名、歴史を答える用途なら、ここを見るべきだ。
もう1つの tengu_bench は難易度の高い総合タスクで、識別力が高い。総合では上位の Gemma 4 26B-A4B がここでは 0.7522 と下位に沈む。つまり「日本知識は得意、難しい総合推理は苦手」という向き不向きが、サブセットを見るまで出てこない。
「大きいモデル=日本語が強い」ではない
最たる例が Gemma 4 26B-A4B の逆転だ。rakuda-questions(日本知識・地理歴史)で首位の 0.8975 を叩き出し、428B級を上回った。総パラメータは1/16でも、日本語の知識量で勝つ。日本語用途の選び方は「サイズ」ではなく「どのベンチの、どのサブセットで強いか」で決まる。この視点が、dense時代の「B数で選ぶ」発想との最大の違いだ。
実行環境の選び方
モデルが決まったら、動かすエンジンを選ぶ。2026年夏時点での役割分担は次の通り。
| エンジン | 向いている用途 | 特徴 |
|---|---|---|
| Ollama | 手早く試したい・CLI派 | ollama run だけで開始。APIも公開できる。今回の実測はこちら |
| LM Studio | 初心者・GUI派 | モデル選択から実行までGUIで完結 |
| llama.cpp | 細かく制御したい | 量子化・オフロードの設定幅が広い |
| vLLM | サーバ運用・大量同時処理 | APIサーバとして高スループット。GPU複数枚が前提 |
共通するのは、GGUFなどの同じモデル形式を扱うこと。だからエンジンを変えてもモデルは使い回せる。最初に1つだけ選ぶなら Ollama が簡単だ。
なお今回の実測環境は、Windows 11 Pro(RTX 3060 12GB / RAM 32GB)に Ollama 0.34.4 を入れて、ollama pull で gemma4:12b-it-qat(7.0GB+175MB)と gpt-oss:20b(13GB)を取得した。測定は --think false(thinking無効)で日本語プロンプト72字、4回実行して Run1 を除外した3回平均。Run1 は gemma が 438.75 tok/s(キャッシュヒット)という外れ値を、gpt-oss は TTFT 9,706ms(初回ロード)という極端な値を示したため除外した。この除外理由も含めて、数字の条件は開示しておく。
モデルファイルのダウンロードは数百MB〜20GBになるため、SSD の空き容量を見ておきたい。Windows ならインデックスや仮想メモリの置き場所もSSDに寄せるとなお良い。

VRAM・RAM・SSD のバランスでローカルLLM環境の体感は大きく変わる。特に「VRAMに載せきれない部分」を RAM と SSD(スワップ)がどう受け持つかは、エンジンごとに挙動が違うので、気になる人は推論エンジンの実測比較を参照してほしい。
よくある質問(FAQ)
Q1. 一番おすすめは?
A. VRAM次第。12GBなら Gemma 4 12B(QAT)、24GBなら Gemma 4 26B-A4B、32GBなら Qwen3.6-35B-A3B が本命。迷ったら「VRAM帯別の表」の自分の行を見るだけでいい。
Q2. 12GBで一番まともに動くのは?
A. Gemma 4 12B(QAT)。今回の実測でVRAM 100%搭載・33.77 tok/s。gpt-oss-20b も動くが14GBが載りきれず19.94 tok/s まで落ちる。
Q3. 日本語なら結局どれ?
A. 総合なら DeepSeek V4 Flash(104GB級で個人には重い)を、現実的なサイズなら Qwen3.6-35B-A3B。日本固有知識重視なら Gemma 4 26B-A4B が狙い目(rakuda首位)。
Q4. 量子化で品質は落ちる?
A. 落ちるが実用上は小さい。ただし「fp16の7B」と「Q4の35B」を比べるなら、総知識量の多い後者が答える質が多いことも多い。Q4 が基本戦になっているのはそのためだ。
Q5. ライセンスはどれが安全?
A. 今回紹介した6モデルはすべて Apache 2.0 か MIT で商用自由。GLM-5.3 本体や Kimi K3 のような独自ライセンスは収益ゲート付きなので注意。一次情報(HFのLICENSE)の確認を習慣にしたい。
Q6. QAT版と通常版どっち?
A. 入れるならQAT版。4bit前提で再学習しているため品質が落ちにくく、今回の実測では100% GPU搭載という効果もあった。Ollamaならタグで選ぶ(gemma4:12b-it-qat)。
Q7. 大型モデルは個人では無理?
A. 320B〜284Bクラス(GLM / DeepSeek)は128GB統合メモリ機が現実的な枠。手持ちの12〜24GB機では、Active量の小さいMoE(Qwen3.6やGemma 4 26B)を4bitで入れる範囲が実用圏だ。
Q8. クラウドとどっちが安い?
A. 利用量が限られればクラウド、常用・機密データ・大量処理ならローカル。ローカルは初期費用(GPU・電気)が前提になるので、自分が月にどれだけ使うかで逆転点が決まる。機密を外部に出せないなら話は別で、ローカル一択になる。
まとめ
管理人の小職さん
ロボ小職
今回の要点を再掲する。
- 2026年の常識は MoE + 4bit + 投機デコード。「総パラメータ」ではなく「実ファイルサイズとActive量」で見ること
- 12GB帯の実測:Gemma 4 12B(QAT)33.77 tok/s・VRAM 100%搭載、gpt-oss-20b 19.94 tok/s・24% CPU溢れ。境界はファイルサイズで正確に分かる
- 日本語は総合点より JamC-QA などサブセット。総合の差(0.0193幅)は実用上ほぼ誤差
- ライセンスは6モデルとも Apache 2.0 または MIT。ただし最上位モデルの改定には要注意
最後に、正直な範囲をもう一度明示しておく。実測したのは RTX 3060 12GB での Gemma 4 12B(QAT)と gpt-oss-20b の2モデルだけだ。Qwen3.6-35B-A3B と Gemma 4 26B-A4B は 12GB では現実的でないため動かさず、GLM-5.3-Flash と DeepSeek V4 Flash はスペック要件を超えるため実測していない。これら4モデルの数値はすべて出典付きの紹介であり、実測値ではない。ベンチ値も測定者・量子化・judge・モードの条件付きの引用だ。数字の出どころを区別して読むことが、いちばんの失敗防止になる。
自分のVRAMを確認して、早見表の自分の行から始めてみてね。環境構築の入口はfreebuffのセットアップガイドも参照してほしい。次の1台を選ぶときの指針となれば嬉しい。
RECOMMENDED
━━━ こちらもチェック! ━━━
omoiji.com では他にも様々なコンテンツを公開中です!ぜひご覧ください!
(PR)



タグ