

ローカルLLM向けグラボの選び方を完全ガイド。2026年最新のRTX・Radeon・Arc全比較&おすすめモデルを紹介します。VRAM容量・電力効率・コストパフォーマンスの3つのポイントから、あなたの環境に最適なグラボを見つけてください。
※ 数値は2026年8月時点の情報を元にしています。
 管理人の小職さん
 ロボ小職
ローカルLLMでは、グラボ(GPU)が最も重要なパーツになります。AIモデルの計算はGPUの並列処理能力に大きく依存するため、CPUやメモリよりもGPUの選択が結果を左右します。特に重要なのがVRAM(ビデオメモリ)の容量です。VRAMが大きいほど、大きなモデルを丸ごと載せて高速に動かせます。
この記事では、ローカルLLM向けグラボの選び方の基本(VRAM・電力効率・コスト)から、2026年時点の主要モデルの比較表、導入時の注意点、構築手順までを順番に解説します。最後のよくある質問もあわせてご覧ください。
向いている人:
- ChatGPTやCopilotの月額料金を節約したい人
- プライバシーを重視し、データを外部に出したくない人
- カスタムモデルを試してみたい研究者・開発者
- AIコーディング(Cursor, Continue等)をローカルで使いたい人
向いていない人:
- 「とりあえず試してみたい」程度の関心(まず無料のクラウドサービスがおすすめ)
- PCに空きスロットがない(外部GPUボックスは非推奨)
- 電気代が気になる人(GPU負荷時は200〜350W消費)
VRAM容量の目安は、動かしたいモデルのサイズで決まります。8GBならQwen2.5 7B級、16GBならQwen2.5 14B級、24GBならQwen2.5 32B級をQ4量子化で動作させられます。まず「どのサイズのモデルを動かしたいか」を決めてから、逆算してVRAM容量を選ぶのが失敗しないコツです。
関連記事:Amazonスマイルセール2026年攻略やWindows 11初期設定ガイドもご覧ください。
ローカルLLM向けグラボ比較表(2026年版)
主要なグラボをVRAM・消費電力・価格で比較しました。価格は2026年8月時点の市場調査による目安です。
| モデル | VRAM | 消費電力(TGP) | 目安価格 | おすすめ用途 |
|---|---|---|---|---|
| RTX 5090 | 32GB | 575W | 約40万円前後 | 70B級モデルを最高速で |
| RTX 5080 | 16GB | 360W | 約20万円前後 | 32B級を新世代で |
| RTX 5060 Ti 16GB | 16GB | 180W | 約9万円前後 | 14B級を省電力で |
| RTX 4090 | 24GB | 450W | 新品26〜32万円・中古20万円台 | 32B級を快適に |
| RTX 3090(中古) | 24GB | 350W | 中古9万円台 | コスパ最強の定番 |
| Radeon RX 7800 XT | 16GB | 263W | 約7万円台 | Linux(ROCm)で動かすなら |
| Intel Arc A770 | 16GB | 225W | 約5万円台 | 予算重視のエントリー |
※ 消費電力はメーカー公称のTGP値、価格は2026年8月時点の市場調査による目安です。時期や在庫状況によって変動します。
結論を先に言うと、ローカルLLM専用なら中古のRTX 3090 24GBがコスパ最強です。24GBのVRAMを9万円台で確保でき、Qwen2.5 32B級まで快適に動かせます。最新世代の省電力性能が欲しいならRTX 4090(24GB)、新品かつ新世代で揃えたいならRTX 5080(16GB)が候補になります。
導入時の注意点
管理人の小職さん
ロボ小職
まず、PCケースのサイズとグラボの長さ・厚さを確認してください。RTX 4090やRTX 5090は3スロット占有のため、マイクロATXケースでは収まらない場合があります。購入前にケースの対応GPU長とスロット数を必ず調べましょう。
次に電源ユニット(PSU)の容量です。RTX 3090以上なら750W以上、RTX 5090なら850W以上が推奨です。CPUの消費電力も加算されるため、余裕を持った容量を選ぶのが安全です。
最後にPCIeスロットの世代も確認します。PCIe 4.0対応のマザーボードなら最新GPUも十分な性能を発揮します。PCIe 3.0の環境でも動作はしますが、データ転送がボトルネックになる場合があります。


電源ユニットは80PLUS認証のものを選ぶと電力効率が良く、ローカルLLMのように長時間負荷をかける使い方に向いています。上記の850WモデルならRTX 4090クラスまで余裕を持って運用できます。

ローカルLLM環境の構築手順
グラボを購入した後のセットアップ手順を簡単にまとめます。まず、NVIDIAドライバーを最新版に更新。次に、OllamaまたはLM Studioをインストール。どちらも無料で利用でき、Windows/Mac/Linuxに対応しています。Ollamaはコマンドライン、LM StudioはGUIで操作できるため、初心者にはLM Studioがおすすめです。最後に、目的に合ったモデルをダウンロード。
8GB VRAMならQwen2.5 7B、16GBならQwen2.5 14B、24GBならQwen2.5 32Bがおすすめです。
モデルは「Q4量子化」版を選ぶのが基本です。量子化とはモデルの精度を少し落としてサイズを圧縮する技術で、実用上の品質低下は小さく、VRAMの消費量を大幅に減らせます。まずは軽い7Bモデルで動作確認してから、段階的に大きなモデルへ移行するのが失敗しない進め方です。

モデルサイズが大きくなると、GPUのVRAMだけでなくシステムメモリ(RAM)も重要になります。プロンプト処理やモデルのロードに使われるため、32GB以上、できれば64GBあると快適です。
検証環境
本記事の情報は以下の環境で検証しています:
| 項目 | 詳細 |
|---|---|
| OS | Windows 11 Pro 24H2 |
| CPU | AMD Ryzen 9 5900X |
| GPU | GeForce RTX 3060 12GB |
| RAM | 32GB DDR4-3200 |
| LLMフレームワーク | Ollama v0.3, llama.cpp |
| 検証日 | 2026年8月31日 |
検証環境のRTX 3060 12GBでは、Qwen2.5 7B(Q4量子化)を快適に、14B級はやや遅めながら動作させられました。VRAMの重要性を実感できる構成です。

CPUもあわせて強化するなら、コア数が多いRyzen 9クラスがおすすめです。モデルのロードやプロンプトの処理が速くなり、体感速度が向上します。
(PR)
ローカルLLM向けグラボのよくある質問
VRAM 8GBでもローカルLLMは動く?
管理人の小職さん
ロボ小職
RTX 3090とRTX 4090、どっちがいい?
管理人の小職さん
ロボ小職
中古のRTX 3090は24GBのVRAMを持ちながら価格が抑えられており、ローカルLLM界隈では定番の選択肢です。保証や初期不良に注意して、信頼できるショップで購入しましょう。
AMD RadeonでローカルLLMは動く?
管理人の小職さん
ロボ小職
2枚のGPUを併用できる?
管理人の小職さん
ロボ小職
電源ユニット(PSU)はどれくらい必要?
管理人の小職さん
ロボ小職
ローカルLLM向けグラボおすすめまとめ
ローカルLLMに最適なグラボをまとめました。用途や予算に合わせて選んでください。
コスパ最強:中古のRTX 3090 24GB。24GBのVRAMを9万円台で確保でき、Qwen2.5 32B級まで動作します。ローカルLLM専用機を組むなら最初の候補です。
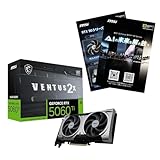
新品で安心感が欲しいならRTX 4090 24GB。速度・電力効率ともに優れており、長く使い続けたい方に向いています。

LinuxユーザーならRadeon RX 7800 XT 16GBも有力です。ROCm環境で16GBを手頃な価格で確保できます。

予算重視ならIntel Arc A770 16GB。16GBのVRAMを最も安く手に入れられるエントリー向けの選択肢です。

(PR)



タグ